

Kurzantwort
Textdateien durchsuchen: Verwenden Sie grep oder ripgrep für Klartext, Code, Protokolle und Konfigurationsdateien.
Dokumente durchsuchen: Verwenden Sie eine Desktop-Anwendung für PDF-, Word-, Excel- und LibreOffice-Dateien und mehr.
Sie suchen stattdessen nach dem Dateinamen: Verwenden Sie find oder locate.
Ich habe zahlreiche Linux-Befehle und -Anwendungen für die Dateisuche getestet – weit mehr als die hier behandelten – und die praktischsten und effektivsten Methoden ausgewählt. Ich habe die Beispiele unter Ubuntu mit derselben Sammlung von TXT-, PDF-, ODT-, DOCX- und anderen Dateien getestet, die im gesamten Artikel verwendet wird.
Wählen Sie zunächst anhand der folgenden Tabelle die richtige Methode aus und lesen Sie dann den entsprechenden Abschnitt.
Welche Linux-Suchmethode sollten Sie verwenden?
Die beste Methode hängt hauptsächlich davon ab, welche Dateitypen Sie durchsuchen müssen.
| Aufgabe | Beste Option |
| Textdateien mit einem standardmäßigen Linux-Befehl durchsuchen | grep |
| Textdateien in großen Ordnern schnell durchsuchen | ripgrep |
| Eine Datei anhand ihres Namens statt ihres Inhalts finden | find oder locate |
| PDF-, Word-, LibreOffice-, Excel- und andere Dokumente durchsuchen | SeekFast |
| Ein kostenloses, quelloffenes und indexbasiertes Tool zur Dokumentensuche verwenden | Recoll oder DocFetcher |
Die Tools grep und ripgrep durchsuchen den Inhalt von Textdateien, während find und locate nach Dateinamen und Pfaden suchen. Diese Tools eignen sich hervorragend für technische Dateien, können aber komplexe Dokumentformate nicht zuverlässig durchsuchen. Deshalb ist für einen Ordner voller Dokumente eine andere Lösung die richtige als für einen Ordner voller Protokolle oder Code.
Text in Dateien mit dem Befehl grep suchen
Der Befehl grep ist das Standardtool unter Linux, um Text in Dateien zu finden. Er eignet sich am besten für Klartext, Quellcode, Protokolle, CSV-Dateien, Markdown-Dateien und Konfigurationsdateien.
Um in den .txt-Dateien im aktuellen Ordner nach einem Wort zu suchen, verwenden Sie:
grep "budget" *.txt
Um einen Ordner und alle seine Unterordner zu durchsuchen, verwenden Sie die rekursive Suche:
grep -R "budget" ~/Documents/stories
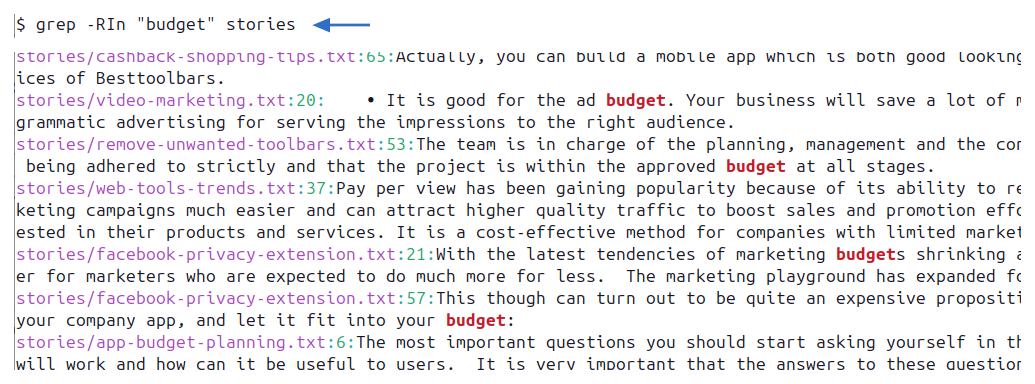
In der Praxis füge ich normalerweise Zeilennummern und Dateinamen hinzu, da sich die Ergebnisse dadurch leichter verwenden lassen:
grep -RIn "budget" ~/Documents/stories
Die Optionen haben folgende Bedeutung:
- -R durchsucht Ordner rekursiv.
- -I überspringt Binärdateien.
- -n zeigt Zeilennummern an.
Groß- und Kleinschreibung ignorieren
Um Unterschiede zwischen Groß- und Kleinschreibung zu ignorieren, fügen Sie -i hinzu:
grep -RIn -i "report" ~/Documents/stories
Damit lassen sich „report“, „Report“ und „REPORT“ finden.
Nur nach ganzen Wörtern suchen
Um nur ein ganzes Wort zu finden, fügen Sie -w hinzu:
grep -RIn -w "policy" ~/Documents/stories
Dadurch werden Treffer innerhalb längerer Wörter wie „policyholder“ vermieden.
Nur bestimmte Dateitypen durchsuchen
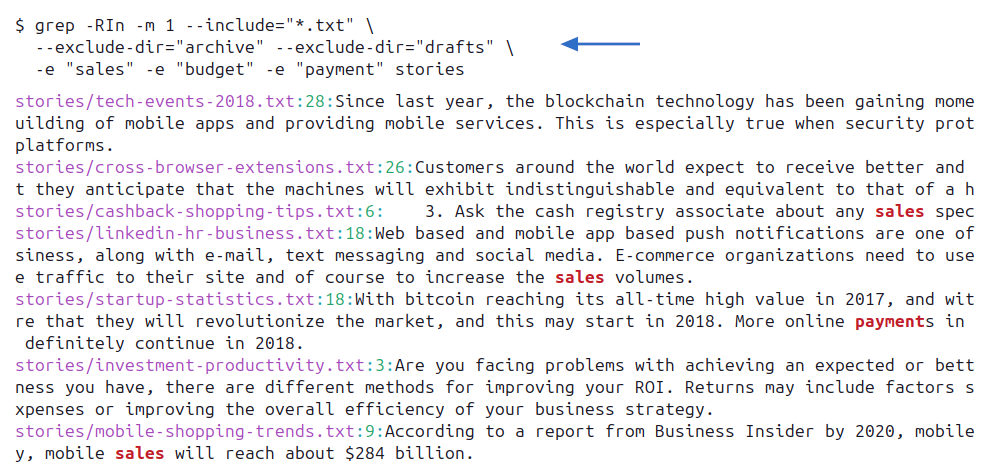
Um nur Dateien mit einer bestimmten Erweiterung zu durchsuchen, verwenden Sie --include:
grep -RIn --include="*.txt" "budget" ~/Documents/stories
Wiederholen Sie die Option für mehrere Erweiterungen:
grep -RIn --include="*.txt" --include="*.md" "budget" ~/Documents/stories
Das ist bei Ordnern nützlich, die viele Dateitypen enthalten, wenn Sie nur textbasierte Dateien durchsuchen möchten.
Ordner von der Suche ausschließen
Große Ordner enthalten häufig Verzeichnisse, die Sie nicht durchsuchen möchten, etwa archive, drafts oder Sicherungskopien. Sie können sie folgendermaßen ausschließen:
grep -RIn --exclude-dir="archive" --exclude-dir="drafts" "risk" ~/Documents/stories
Dadurch bleiben die Ergebnisse übersichtlicher und die Suche kann wesentlich schneller werden.
Nach einer exakten Wortgruppe oder mehreren Zeichenfolgen suchen
Setzen Sie eine exakte Wortgruppe in Anführungszeichen:
grep -RIn "sales report" ~/Documents/stories
Um nach einer von mehreren Zeichenfolgen zu suchen, fügen Sie für jede Zeichenfolge eine Option -e hinzu:
grep -RIn -e "sales" -e "budget" -e "payment" ~/Documents/stories
Mit -E können Sie auch erweiterte reguläre Ausdrücke verwenden:
grep -RInE "customer|product|service" ~/Documents/stories
Beide Befehle finden eine Zeile, die mindestens eine der Zeichenfolgen enthält. Wenn Sie Dateien benötigen, die sowohl „sales“ als auch „payment“ enthalten – selbst in unterschiedlichen Zeilen –, filtern Sie die Dateinamen in zwei Schritten:
grep -RIlZ "sales" ~/Documents/stories | xargs -0 -r grep -Il "payment"
Das sind die am häufigsten verwendeten Anwendungsfälle des Befehls grep. Eine vollständige Referenz finden Sie im GNU-grep-Handbuch.
Wenn grep nicht ausreicht
Der Befehl grep ist leistungsstark, bleibt aber ein Suchtool für Klartext. Er funktioniert normalerweise gut bei Dateien, die als lesbarer Text gespeichert sind. Als allgemeine Lösung für Word-Dokumente, Excel-Tabellen, LibreOffice-Dateien, PDFs, E-Books oder andere Dokumentformate ist er nicht geeignet.
Wenn Sie grep für einen Ordner voller unterschiedlicher Dokumente verwenden, übersehen Sie häufig wichtige Treffer oder erhalten unleserliche Ausgaben. Springen Sie in diesen Fällen direkt zu den Tools zur Dokumentensuche.
Ripgrep für eine schnellere Suche über die Befehlszeile verwenden
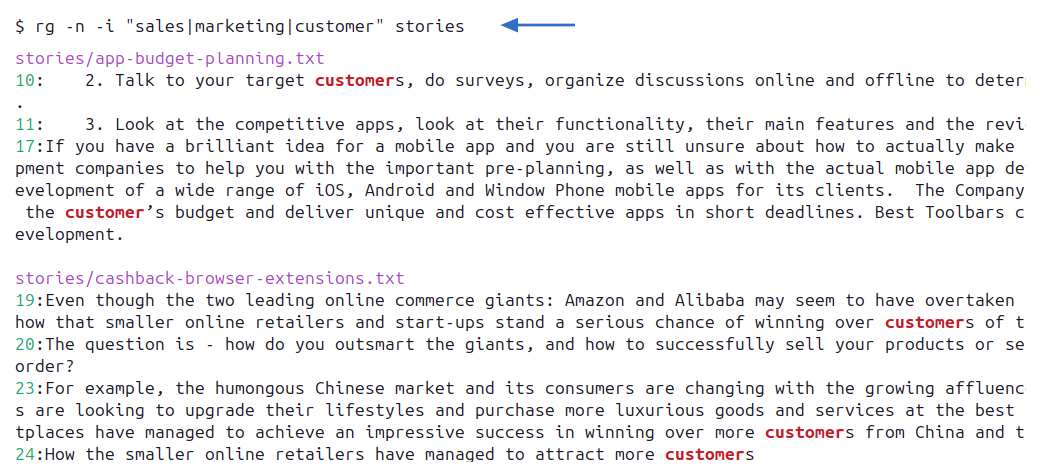
Das Tool ripgrep, das normalerweise als rg ausgeführt wird, ist ein modernes Suchtool für die Befehlszeile. Im offiziellen ripgrep-Leitfaden wird erklärt, dass es Verzeichnisse standardmäßig rekursiv durchsucht und automatische Filter anwendet. Bei rekursiven Suchen in großen Code- und Textordnern ist es häufig schneller als das standardmäßige grep.
Um den aktuellen Ordner und seine Unterordner zu durchsuchen, verwenden Sie:
rg "budget"
Um einen bestimmten Ordner zu durchsuchen:
rg "budget" ~/Documents/stories
Um nur bestimmte Dateitypen zu durchsuchen:
rg "budget" -g "*.txt" ~/Documents/stories
Das Tool ripgrep berücksichtigt standardmäßig auch .gitignore. Das ist bei Quellcodeprojekten hilfreich, weil dadurch viele generierte oder irrelevante Dateien automatisch übersprungen werden.
Verwenden Sie ripgrep, wenn Sie Code, Protokolle, Markdown-, Konfigurations- oder andere Klartextdateien durchsuchen. Für PDF-, Word-, LibreOffice-, Excel- und andere Dokumente sollten Sie stattdessen ein Tool zur Dokumentensuche verwenden.
Was sollten Sie verwenden: grep oder ripgrep?
Beide Tools durchsuchen Klartextinhalte, eignen sich jedoch für etwas unterschiedliche Arbeitsabläufe:
- Verwenden Sie grep als Standardbefehl, der auf nahezu jedem Linux-System bereits verfügbar ist.
- Verwenden Sie ripgrep für schnelle rekursive Suchen in Code-Repositorys und großen Textordnern.
- Das Tool ripgrep durchsucht standardmäßig Unterordner und berücksichtigt
.gitignore, während für den Befehl grep rekursive Optionen erforderlich sind und die Suche wörtlicher erfolgt, sofern Sie keine Pfade ausschließen. - Verwenden Sie für PDF-, Word-, Excel-, LibreOffice- und andere komplexe Dokumentformate statt beider Befehle ein Tool zur Dokumentensuche.
So installieren Sie ripgrep unter Ubuntu, Mint, Fedora, Debian und anderen Linux-Distributionen
Die Suchbefehle von ripgrep sind bei allen Linux-Distributionen gleich. Lediglich der Installationsbefehl unterscheidet sich je nach Paketmanager. Die folgenden Befehle entsprechen der offiziellen Installationsanleitung für ripgrep.
| Distribution | ripgrep installieren |
| Ubuntu, Linux Mint, Debian | sudo apt install ripgrep |
| Fedora | sudo dnf install ripgrep |
| openSUSE | sudo zypper install ripgrep |
| Arch Linux | sudo pacman -S ripgrep |
Dateien und Verzeichnisse unter Linux anhand ihres Namens finden
Wenn Sie den vollständigen Namen oder einen Teil des Namens einer Datei kennen, verwenden Sie den Befehl find. Das GNU-Findutils-Handbuch dokumentiert die Filter nach Dateiname, Zeit, Größe und weiteren Eigenschaften. Der Befehl durchsucht nicht den in Dateien gespeicherten Text; verwenden Sie dafür grep oder ripgrep.
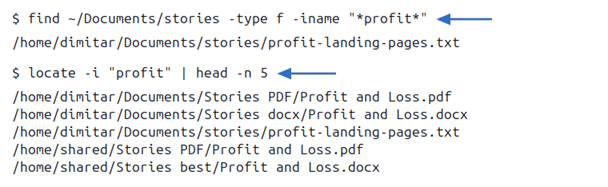
Um im Ordner stories und seinen Unterordnern Dateien zu finden, deren Namen ein bestimmtes Wort enthalten, verwenden Sie:
find ~/Documents/stories -type f -iname "*profit*"
Verwenden Sie -iname für einen Teiltreffer ohne Berücksichtigung der Groß- und Kleinschreibung:
find ~/Documents/stories -type f -iname "*shopping*"
Die Sternchen entsprechen beliebigen Zeichen vor oder nach „shopping“. Um statt einer Datei ein Verzeichnis zu finden, ändern Sie -type f in -type d:
find ~/Documents/stories -type d -iname "*archive*"
Sie können Dateien auch nach Erweiterung, Änderungsdatum oder Größe filtern:
find ~/Documents/stories -type f -iname "*.pdf"
find ~/Documents/stories -type f -mtime -7
find ~/Documents/stories -type f -size +100M
Diese Befehle finden der Reihe nach PDF-Dateien, Dateien, die ungefähr innerhalb der letzten sieben Tage geändert wurden, und Dateien, die größer als 100 MB sind.
Dateien mit locate schneller finden
Der Befehl locate durchsucht eine Dateinamendatenbank, statt jedes Mal das Dateisystem zu scannen. Daher ist die Suche nach Dateinamen normalerweise deutlich schneller als mit find. Im plocate-Handbuch wird erklärt, wie diese indexbasierte Suche funktioniert:
locate -i "profit"
Da locate einen Index verwendet, werden sehr neue Dateien möglicherweise erst angezeigt, nachdem die Datenbank aktualisiert wurde. Auf Systemen, auf denen Sie die Berechtigung zum Aktualisieren besitzen, verwenden Sie:
sudo updatedb
Verwenden Sie find, wenn Sie aktuelle Ergebnisse oder detaillierte Filter benötigen. Verwenden Sie locate, wenn Sie einen vorhandenen Dateinamen möglichst schnell an indexierten Speicherorten nachschlagen möchten.

Die besten Tools zur Dokumentensuche für Linux
Die Tools grep und ripgrep sind für Klartext ausgelegt. Verwenden Sie zum Durchsuchen von PDF-, Word-, Excel- und LibreOffice-Dateien, E-Books und anderen Formaten eine der folgenden Anwendungen zur Dokumentensuche; reine Bildscans im PDF-Format müssen zuerst per OCR verarbeitet werden.
SeekFast eignet sich besonders, wenn Sie Ordner mit verschiedenen Dokumenttypen durchsuchen, passende Sätze als Vorschau anzeigen und nach Relevanz sortierte Ergebnisse erhalten möchten, ohne im Terminal arbeiten zu müssen. Es ist besonders praktisch, wenn Sie einen neuen oder häufig veränderten Ordner durchsuchen müssen.
Recoll und DocFetcher sind eine gute Wahl, wenn Sie kostenlose, quelloffene Software bevorzugen und bereit sind, vorab einen Index zu erstellen. Die Indexierung erfordert etwas Vorbereitung, kann aber wiederholte Suchen in einer bestehenden Dokumentensammlung praktischer machen.
Die ChatGPT-Desktop-App verfolgt einen anderen Ansatz. Sie kann mit von Ihnen ausgewählten Ordnern arbeiten, Fragen in natürlicher Sprache beantworten, Dateien vergleichen und Ergebnisse zusammenfassen. Sie eignet sich am besten als Ergänzung, wenn Sie die Informationen verstehen möchten, und nicht als einziges Tool für umfassende Suchen nach exakten Übereinstimmungen.
SeekFast
SeekFast ist ein Tool zur Dokumentensuche für Windows, macOS und Linux. Es wurde dafür entwickelt, große Dokumentensammlungen zu durchsuchen, statt lediglich Klartextdateien über das Terminal zu durchsuchen.
Der größte Vorteil ist der Komfort. Sie wählen einen Ordner aus, geben Ihre Suchbegriffe ein und sehen die passenden Sätze, bevor Sie die jeweilige Datei öffnen. Das ist nützlich, wenn Sie den genauen Dateinamen nicht kennen und viele Dokumente durchsuchen müssen.
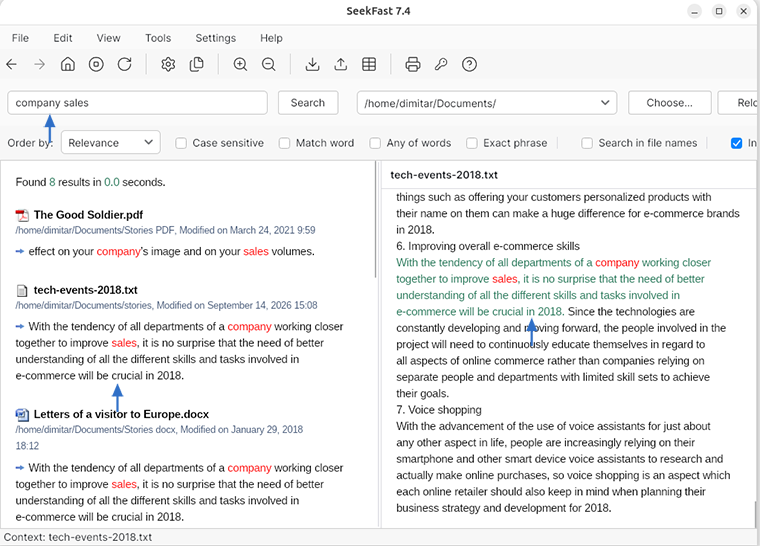
SeekFast ist besonders nützlich, wenn Ihr Ordner verschiedene Dokumenttypen enthält, da es zahlreiche Formate durchsuchen und die Ergebnisse nach Relevanz sortieren kann. Dadurch ähnelt die Suche eher einer Websuche als einer herkömmlichen Dateisuche nach exakten Übereinstimmungen.
Zu den wichtigsten Funktionen gehören:
- Dokumentensuche – Durchsuchen Sie mehr als 120 unterstützte Dateiformate, darunter PDF-, Word-, LibreOffice-, Excel- und Textdateien sowie E-Books.
- Vorschau passender Sätze – Sehen Sie den relevanten Text, bevor Sie die Datei öffnen.
- Nach Relevanz sortierte Ergebnisse – Dateien mit besseren Treffern erscheinen weiter oben in den Ergebnissen.
- Suche nach mehreren Schlüsselwörtern – Finden Sie Dokumente auch dann, wenn die Wörter nicht direkt nebeneinanderstehen.
- Grafischer Arbeitsablauf – Für häufige Aufgaben bei der Dokumentensuche müssen keine Terminalbefehle zusammengestellt werden.
Vorteile
- Für Ordner mit echten Dokumenten wesentlich komfortabler als grep.
- Funktioniert gut, wenn Sie sich an Wörter aus dem Dokument, aber nicht an den Dateinamen erinnern.
- Zeigt den Kontext an, sodass Sie die Ergebnisse beurteilen können, bevor Sie Dateien öffnen.
- Nützlich für gemischte Ordner mit PDF-, Office-, LibreOffice-, Text- und anderen Formaten.
Nachteile
- Die kostenlose Version von SeekFast ist auf die gleichzeitige Suche in bis zu 50 Dateien beschränkt.
- SeekFast ist nicht als Ersatz für grep oder ripgrep bei der Quellcodesuche gedacht.
- Fortgeschrittene Arbeitsabläufe mit regulären Ausdrücken wie bei spezialisierten Befehlszeilentools werden nicht unterstützt.
Wenn Ihre Hauptaufgabe darin besteht, viele Dokumente zu durchsuchen, anstatt Code oder Protokolldateien zu durchsuchen, laden Sie SeekFast herunter und testen Sie es mit einem Ihrer Dokumentordner.
Recoll
Recoll ist ein kostenloses, quelloffenes Desktop-Suchtool für Linux und andere Unix-ähnliche Systeme. Es verwendet einen Index. Das bedeutet, dass es zunächst die von Ihnen ausgewählten Ordner scannt und Sie anschließend schnell darin suchen können.
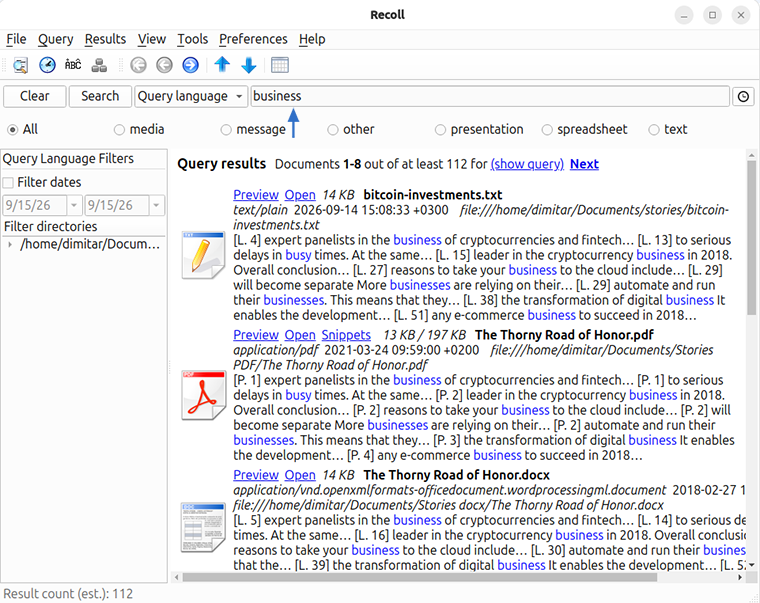
Die Unterstützung einiger Dokumentformate hängt von Hilfsanwendungen ab, die auf Ihrem System installiert sind. Recoll ist eine gute Wahl, wenn Sie ein quelloffenes, indexbasiertes Desktop-Suchtool wünschen und etwas Zeit für die Konfiguration aufwenden können.
Vorteile
- Kostenlos und quelloffen.
- Funktioniert gut als indexbasiertes Linux-Desktop-Suchtool.
- Kann mit den richtigen Hilfsprogrammen zahlreiche Dokumentformate durchsuchen.
Nachteile
- Die anfängliche Indexierung und Konfiguration können einige Zeit in Anspruch nehmen.
- Der Arbeitsablauf kann für Gelegenheitsnutzer technisch wirken.
- Die Unterstützung von Dokumentformaten kann von den installierten Systempaketen abhängen.
DocFetcher
DocFetcher ist eine kostenlose, quelloffene Desktop-Suchanwendung für Linux, Windows und macOS. DocFetcher Pro ist eine separate kostenpflichtige Version mit zusätzlichen Funktionen. Wie Recoll erstellt die Anwendung Indizes für die von Ihnen ausgewählten Ordner.
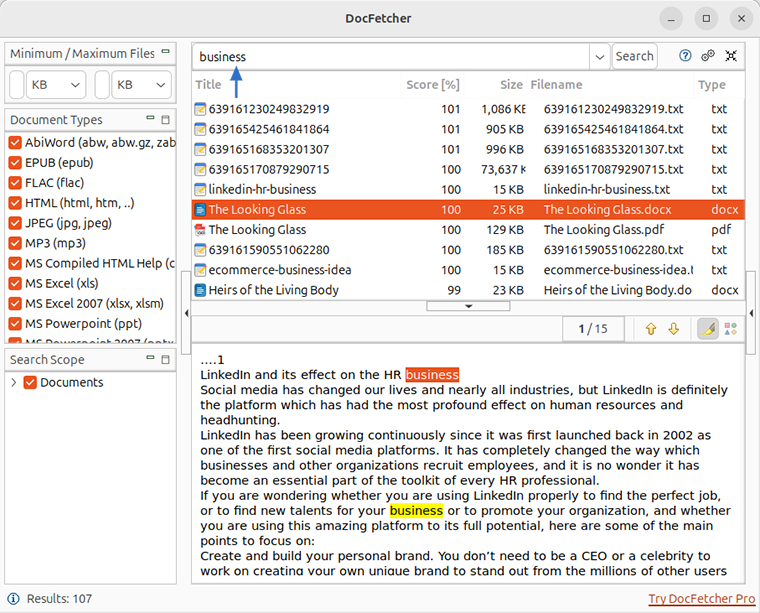
DocFetcher unterstützt gängige Dokumentformate wie PDF, Microsoft Office, OpenDocument, HTML und Klartext. Das Tool kann nützlich sein, wenn Sie eine kostenlose plattformübergreifende Lösung wünschen und bereit sind, vor der Suche Indizes zu erstellen.
Vorteile
- Die Standardausgabe von DocFetcher ist kostenlos und quelloffen.
- Für Linux, Windows und macOS verfügbar.
- Kann Textvorschauen aus indexierten Dokumenten anzeigen.
Nachteile
- Sie müssen einen Index erstellen, bevor Sie den Inhalt eines Ordners durchsuchen können.
- Die Benutzeroberfläche wirkt älter als die vieler moderner Suchtools.
- Weniger praktisch, wenn Sie häufig einmalig verwendete Ordner durchsuchen, ohne zuvor einen Index zu erstellen.
ChatGPT-Desktop-App
Die ChatGPT-Desktop-App ist als Vorabversion für unterstützte Linux-Distributionen verfügbar. Sie ist kein herkömmliches Programm zur Dateisuche. Stattdessen handelt es sich um einen KI-Arbeitsbereich, der mit den Dateien in den von Ihnen ausgewählten Ordnern arbeiten kann.
Um die App mit lokalen Dateien zu verwenden, öffnen Sie in ChatGPT Work oder Codex einen lokalen Ordner und gewähren Sie Zugriff auf die Dateien, die Sie verwenden möchten. Anschließend können Sie Fragen in natürlicher Sprache stellen, zum Beispiel:
- „Finde die Dokumente, in denen Geschäftsrisiken erörtert werden.“
- „Vergleiche die Verkaufsberichte und zeige die wichtigsten Unterschiede.“
- „Finde die Informationen zu diesem Projekt und fasse sie zusammen.“
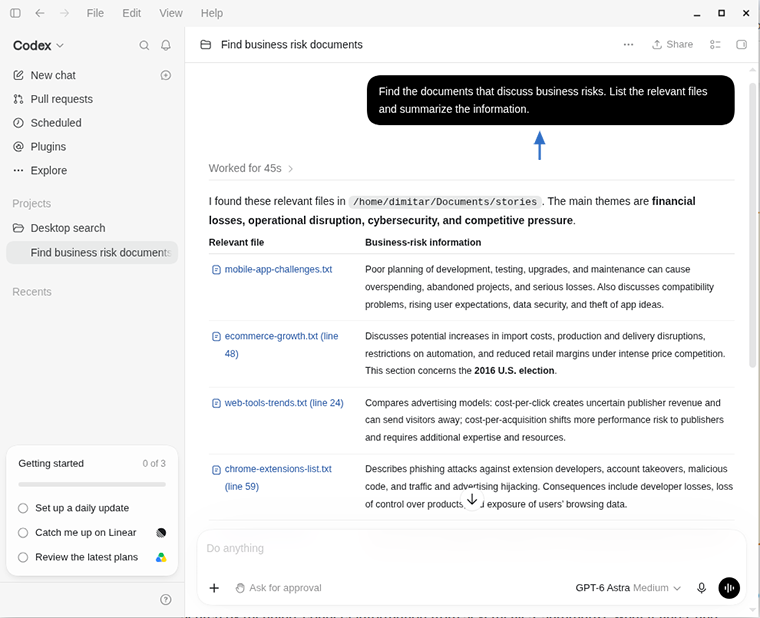
Dieser Ansatz ist besonders nützlich, wenn Sie sich nicht mehr an die genaue Formulierung erinnern. ChatGPT kann nach der Bedeutung suchen, Informationen aus mehreren Dateien miteinander verknüpfen, gefundene Inhalte zusammenfassen und die Ergebnisse erklären. Codex kann außerdem Quellcodeprojekte durchsuchen und analysieren.
Vorteile
- Akzeptiert Fragen in natürlicher Sprache anstelle von ausschließlich Schlüsselwörtern oder regulären Ausdrücken.
- Kann Informationen aus mehreren Dateien zusammenfassen, vergleichen und interpretieren.
- Nützlich, wenn der nächste Schritt darin besteht, die Ergebnisse zu verstehen und nicht nur eine Wortgruppe zu finden.
Nachteile
- ChatGPT ist nicht darauf ausgelegt, garantiert jedes exakte Vorkommen zu finden. Verwenden Sie daher grep oder ripgrep, wenn Vollständigkeit wichtig ist.
- ChatGPT bietet nicht denselben spezialisierten Arbeitsablauf für die indexbasierte Suche wie SeekFast, Recoll oder DocFetcher.
- Die Linux-Version befindet sich noch in der Vorschauphase und unterstützt offiziell nur ausgewählte Distributionen.
- Sie benötigen ein ChatGPT-Konto und die Anwendung nutzt Onlinedienste, statt vollständig offline zu arbeiten. Lesen Sie vor der Verwendung mit vertraulichen Dokumenten nach, wie OpenAI Daten von ChatGPT und Codex verwendet, und prüfen Sie Ihre Datenschutzanforderungen.
Verwenden Sie ChatGPT als Ergänzung zu herkömmlichen Suchtools: grep und ripgrep eignen sich besser für exakte Textsuchen, Anwendungen zur Dokumentensuche sind besser zum Durchsuchen von Sammlungen mit vorhersehbaren Ergebnissen geeignet und ChatGPT ist nützlich, wenn Sie gefundene Informationen verstehen, vergleichen oder zusammenfassen möchten.
Fazit
In diesem Artikel habe ich die Methoden vorgestellt, die sich in meinen Tests zum Finden von Dateien und Durchsuchen ihrer Inhalte unter Linux am besten bewährt haben. Linux-Benutzer haben jedoch häufig ihre eigenen bevorzugten Tools und Arbeitsabläufe. Welche Methode verwenden Sie? Habe ich einen nützlichen Befehl oder eine Anwendung übersehen?
Sie können Ihre Erfahrungen auf eine der folgenden Arten teilen:
- Hinterlassen Sie über das unten stehende Formular einen Kommentar.
- Beteiligen Sie sich an unserer Diskussion auf Reddit.
Häufig gestellte Fragen
1. Wie finde ich unter Linux eine Datei anhand ihres Namens?
Verwenden Sie den Befehl find. Zum Beispiel:
find ~/Documents/stories -type f -iname "*profit*"
Damit werden der Ordner stories und seine Unterordner nach Dateinamen durchsucht, die „profit“ enthalten, wobei die Groß- und Kleinschreibung ignoriert wird.
2. Was ist der Unterschied zwischen find und grep?
Der Befehl find durchsucht Dateinamen, Pfade und Dateieigenschaften. Der Befehl grep durchsucht den Text, der in Klartextdateien gespeichert ist. Wenn Sie den Dateinamen kennen, verwenden Sie find. Wenn Sie sich an Wörter aus der Datei erinnern, verwenden Sie grep oder ein Tool zur Dokumentensuche.
3. Sollte ich find oder locate verwenden?
Verwenden Sie find für aktuelle Ergebnisse und detaillierte Filter. Verwenden Sie locate für eine schnellere Dateinamensuche in einem zuvor erstellten Index. Neu erstellte Dateien erscheinen möglicherweise erst in locate, nachdem die Datenbank aktualisiert wurde.
4. Wie durchsuche ich alle Dateien in einem Linux-Ordner nach Text?
Der Befehl grep -R ist die Standardoption. Zum Beispiel:
grep -RIn "budget" ~/Documents/stories
Das funktioniert am besten für Klartextdateien, Quellcode, Protokolle und Konfigurationsdateien.
5. Wie durchsuche ich auch Unterordner?
Verwenden Sie die rekursive Suche mit grep -R:
grep -RIn "budget" ~/Documents/stories
Dieser Befehl durchsucht den Ordner stories und seine Unterordner, überspringt Binärdateien und zeigt Zeilennummern an.
6. Wie durchsuche ich nur bestimmte Dateitypen?
Verwenden Sie --include. Zum Beispiel:
grep -RIn --include="*.txt" "budget" ~/Documents/stories
Sie können --include für mehrere Erweiterungen wiederholen.
7. Wie schließe ich Ordner von der grep-Suche aus?
Verwenden Sie --exclude-dir. Zum Beispiel:
grep -RIn --exclude-dir="archive" --exclude-dir="drafts" "risk" ~/Documents/stories
8. Wie suche ich nach mehreren möglichen Wörtern?
Fügen Sie für jede Zeichenfolge eine Option -e hinzu. Zum Beispiel:
grep -RIn -e "sales" -e "budget" -e "payment" ~/Documents/stories
Damit werden Zeilen gefunden, die eine der Zeichenfolgen enthalten.
9. Ist ripgrep besser als grep?
Das Tool ripgrep ist bei rekursiven Suchen in großen Code- und Textordnern häufig schneller und komfortabler, während der Befehl grep standardmäßig auf nahezu jedem Linux-System verfügbar ist und sich ideal für gewöhnliche Textsuchen eignet. Keines der beiden ist ein allgemeines Tool zur Dokumentensuche.
10. Warum findet grep keinen Text in meinen PDF- oder Word-Dateien?
Der Befehl grep wurde für Klartext entwickelt. PDF-, Word-, LibreOffice- und Excel-Dateien speichern Text in komplexeren Formaten. Deshalb kann grep Treffer übersehen oder unleserliche Ausgaben anzeigen. Verwenden Sie für diese Dateien ein Tool zur Dokumentensuche.
11. Wie durchsuche ich PDF-, Word- und LibreOffice-Dateien unter Linux am besten?
Verwenden Sie ein Suchtool, das Dokumentformate unterstützt. SeekFast ist praktisch, wenn Sie Vorschauen und nach Relevanz sortierte Ergebnisse wünschen. Recoll und DocFetcher sind gute quelloffene Alternativen, wenn Sie eine indexbasierte Desktop-Suche bevorzugen.
12. Funktioniert SeekFast unter Linux?
Ja. SeekFast ist in einer Linux-Version verfügbar und kann über eine grafische Benutzeroberfläche zahlreiche Dokumentformate durchsuchen.
13. Sollte ich grep, ripgrep oder SeekFast verwenden?
Verwenden Sie grep für gewöhnliche Klartextsuchen. Verwenden Sie ripgrep für schnelle rekursive Suchen in Code- und Textordnern. Verwenden Sie SeekFast, wenn Sie PDF-, Word-, LibreOffice-, Excel- und andere Dokumente mit Vorschau durchsuchen müssen.
