

빠른 답변
텍스트 파일 검색: 일반 텍스트, 코드, 로그 및 설정 파일에는 grep 또는 ripgrep을 사용하세요.
문서 내부 검색: PDF, Word, Excel, LibreOffice 등을 검색하려면 데스크톱 앱을 사용하세요.
내용이 아니라 파일 이름으로 찾고 계신가요? find 또는 locate를 사용하세요.
여기에서 다룬 것보다 훨씬 많은 다양한 Linux 파일 검색 명령어와 애플리케이션을 테스트한 후, 가장 실용적이고 효과적인 방법을 선정했습니다. 이 글 전체에서 사용한 것과 동일한 TXT, PDF, ODT, DOCX 및 기타 파일 모음을 사용하여 Ubuntu에서 예제를 테스트했습니다.
먼저 아래 표에서 적합한 방법을 선택한 다음, 관련 섹션을 확인하세요.
어떤 Linux 검색 방법을 사용해야 할까요?
가장 적합한 방법은 주로 검색하려는 파일 유형에 따라 달라집니다.
| 작업 | 최적의 옵션 |
| 표준 Linux 명령어로 텍스트 파일 검색 | grep |
| 대용량 폴더에서 텍스트 파일을 빠르게 검색 | ripgrep |
| 내용이 아니라 이름으로 파일 찾기 | find 또는 locate |
| PDF, Word, LibreOffice, Excel 및 기타 문서 내부 검색 | SeekFast |
| 무료 오픈 소스 색인 기반 문서 검색 도구 사용 | Recoll 또는 DocFetcher |
grep과 ripgrep 도구는 텍스트 파일 내부를 검색하고, find와 locate는 파일 이름과 경로를 검색합니다. 이러한 도구는 기술 관련 파일에 매우 유용하지만, 복잡한 문서 형식 내부를 안정적으로 검색하지는 못합니다. 따라서 문서로 가득 찬 폴더에 적합한 방법은 로그나 코드로 가득 찬 폴더에 적합한 방법과 다릅니다.
grep 명령어로 파일 내 텍스트 검색하기
grep 명령어는 파일에서 텍스트를 찾는 표준 Linux 도구입니다. 일반 텍스트, 소스 코드, 로그, CSV 파일, Markdown 파일 및 설정 파일에 가장 적합합니다.
현재 폴더의 .txt 파일에서 단어를 검색하려면 다음을 사용하세요.
grep "budget" *.txt
폴더와 모든 하위 폴더를 검색하려면 재귀 검색을 사용하세요.
grep -R "budget" ~/Documents/stories
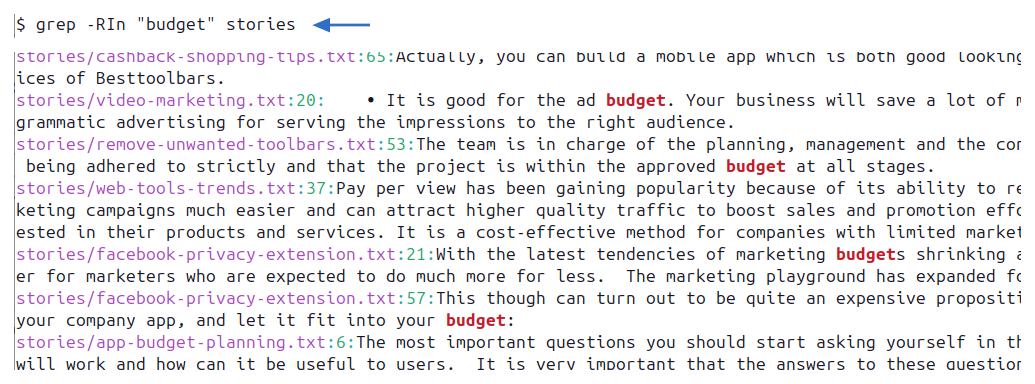
실제로는 결과를 더 쉽게 활용할 수 있도록 보통 줄 번호와 파일 이름을 추가합니다.
grep -RIn "budget" ~/Documents/stories
각 옵션의 의미는 다음과 같습니다.
- -R은 폴더를 재귀적으로 검색합니다.
- -I는 바이너리 파일을 건너뜁니다.
- -n은 줄 번호를 표시합니다.
대소문자를 구분하지 않는 검색
대문자와 소문자의 차이를 무시하려면 -i를 추가하세요.
grep -RIn -i "report" ~/Documents/stories
이 명령어는 "report", "Report", "REPORT"를 모두 찾을 수 있습니다.
완전한 단어만 검색하기
완전한 단어와 일치시키려면 -w를 추가하세요.
grep -RIn -w "policy" ~/Documents/stories
이렇게 하면 "policyholder"처럼 더 긴 단어 내부의 일치 항목을 제외할 수 있습니다.
특정 파일 유형만 검색하기
특정 확장자를 가진 파일만 검색하려면 --include를 사용하세요.
grep -RIn --include="*.txt" "budget" ~/Documents/stories
여러 확장자를 검색하려면 옵션을 반복해서 사용하세요.
grep -RIn --include="*.txt" --include="*.md" "budget" ~/Documents/stories
다양한 파일 유형이 들어 있는 폴더에서 텍스트 기반 파일만 검색하려는 경우 유용합니다.
검색에서 폴더 제외하기
대용량 폴더에는 archive, drafts 또는 백업 폴더처럼 검색할 필요가 없는 디렉터리가 포함된 경우가 많습니다. 다음과 같이 제외할 수 있습니다.
grep -RIn --exclude-dir="archive" --exclude-dir="drafts" "risk" ~/Documents/stories
이렇게 하면 결과가 더 깔끔해지고 검색 속도도 훨씬 빨라질 수 있습니다.
정확한 구문 또는 여러 문자열 검색하기
정확한 구문을 검색하려면 구문을 따옴표로 묶으세요.
grep -RIn "sales report" ~/Documents/stories
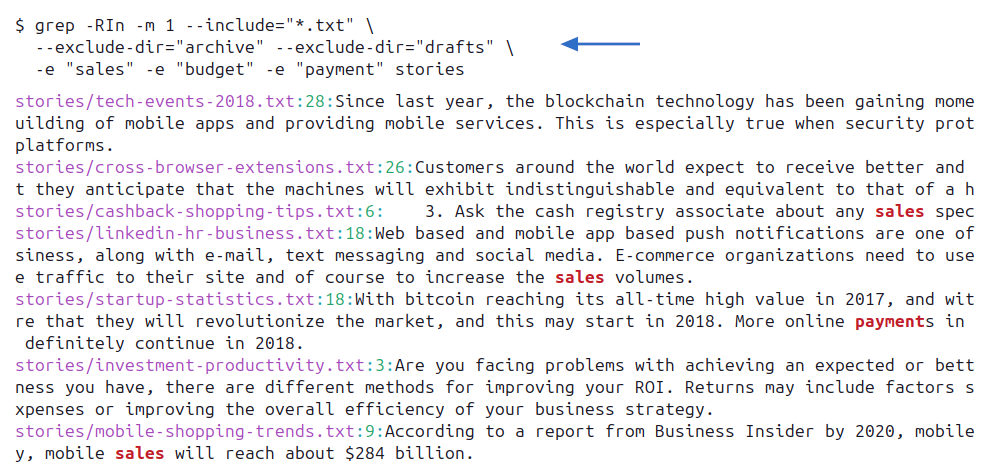
여러 문자열 중 하나라도 검색하려면 각 문자열에 -e 옵션을 하나씩 추가하세요.
grep -RIn -e "sales" -e "budget" -e "payment" ~/Documents/stories
-E를 사용하여 확장 정규 표현식을 이용할 수도 있습니다.
grep -RInE "customer|product|service" ~/Documents/stories
두 명령어 모두 문자열 중 하나 이상이 포함된 줄과 일치합니다. 서로 다른 줄에 있더라도 "sales"와 "payment"가 모두 포함된 파일이 필요하다면 파일 이름을 두 단계로 필터링하세요.
grep -RIlZ "sales" ~/Documents/stories | xargs -0 -r grep -Il "payment"
이것이 grep 명령어의 가장 일반적인 사용 사례입니다. 전체 참고 자료는 GNU grep 설명서를 참조하세요.
grep만으로 충분하지 않은 경우
grep 명령어는 강력하지만 기본적으로 일반 텍스트 검색 도구입니다. 읽을 수 있는 텍스트로 저장된 파일에는 대체로 잘 작동합니다. 그러나 Word 문서, Excel 스프레드시트, LibreOffice 파일, PDF, eBook 또는 기타 문서 형식을 검색하는 일반적인 해결책으로는 적합하지 않습니다.
다양한 문서가 섞여 있는 폴더에서 grep을 사용하면 중요한 일치 항목을 놓치거나 읽을 수 없는 출력이 표시되는 경우가 많습니다. 이러한 경우에는 문서 검색 도구 섹션으로 이동하세요.
더 빠른 명령줄 검색에 ripgrep 사용하기
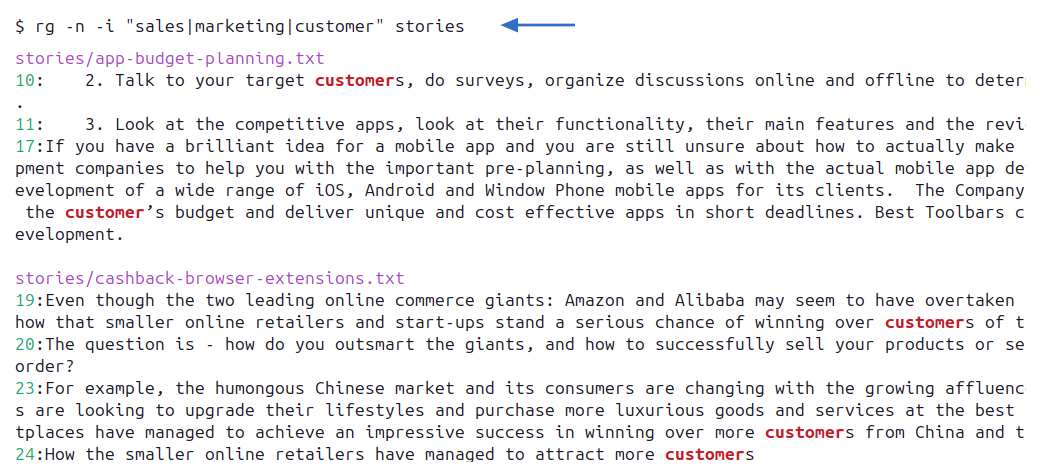
일반적으로 rg로 실행하는 ripgrep은 최신 명령줄 검색 도구입니다. 공식 ripgrep 가이드에 따르면 기본적으로 디렉터리를 재귀적으로 검색하고 자동 필터링을 적용합니다. 대규모 코드 및 텍스트 폴더를 재귀적으로 검색할 때 표준 grep보다 빠른 경우가 많습니다.
현재 폴더와 하위 폴더를 검색하려면 다음을 사용하세요.
rg "budget"
특정 폴더를 검색하려면 다음을 사용하세요.
rg "budget" ~/Documents/stories
특정 파일 유형만 검색하려면 다음을 사용하세요.
rg "budget" -g "*.txt" ~/Documents/stories
또한 ripgrep은 기본적으로 .gitignore를 따르므로, 생성된 파일이나 관련 없는 파일을 자동으로 많이 건너뛸 수 있어 소스 코드 프로젝트에서 유용합니다.
코드, 로그, Markdown, 설정 파일 또는 기타 일반 텍스트를 검색할 때 ripgrep을 사용하세요. PDF, Word, LibreOffice, Excel 및 기타 문서에는 문서 검색 도구를 대신 사용하세요.
grep과 ripgrep 중 무엇을 사용해야 할까요?
두 도구 모두 일반 텍스트 내용을 검색하지만, 약간 다른 작업 방식에 적합합니다.
- 거의 모든 Linux 시스템에서 이미 사용할 수 있는 표준 명령어가 필요하다면 grep을 사용하세요.
- 코드 저장소와 대용량 텍스트 폴더를 빠르게 재귀 검색하려면 ripgrep을 사용하세요.
- ripgrep은 기본적으로 하위 폴더를 검색하고
.gitignore를 따릅니다. 반면 grep 명령어는 재귀 옵션이 필요하며, 경로를 제외하지 않는 한 더 문자 그대로 검색합니다. - PDF, Word, Excel, LibreOffice 및 기타 복잡한 문서 형식에는 두 명령어 대신 문서 검색 도구를 사용하세요.
Ubuntu, Mint, Fedora, Debian 및 기타 Linux 배포판에 ripgrep을 설치하는 방법
ripgrep 검색 명령어는 Linux 배포판에 관계없이 동일합니다. 패키지 관리자에 따라 설치 명령어만 달라집니다. 아래 명령어는 공식 ripgrep 설치 지침을 따릅니다.
| 배포판 | ripgrep 설치 |
| Ubuntu, Linux Mint, Debian | sudo apt install ripgrep |
| Fedora | sudo dnf install ripgrep |
| openSUSE | sudo zypper install ripgrep |
| Arch Linux | sudo pacman -S ripgrep |
Linux에서 이름으로 파일과 디렉터리 찾기
파일 이름의 전체 또는 일부를 알고 있다면 find 명령어를 사용하세요. GNU Findutils 설명서에는 파일 이름, 시간, 크기 및 기타 필터가 설명되어 있습니다. 이 명령어는 파일 내부에 저장된 텍스트를 검색하지 않습니다. 내부 텍스트를 검색하려면 grep 또는 ripgrep을 사용하세요.
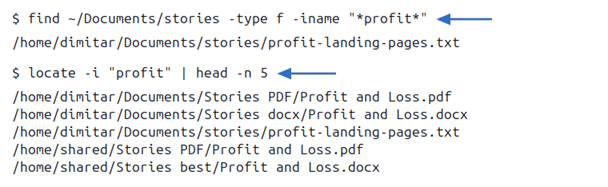
stories 폴더와 하위 폴더에서 이름에 특정 단어가 포함된 파일을 찾으려면 다음을 사용하세요.
find ~/Documents/stories -type f -iname "*profit*"
대소문자를 구분하지 않는 부분 일치에는 -iname을 사용하세요.
find ~/Documents/stories -type f -iname "*shopping*"
별표는 "shopping" 앞뒤의 모든 문자와 일치합니다. 파일 대신 디렉터리를 찾으려면 -type f를 -type d로 변경하세요.
find ~/Documents/stories -type d -iname "*archive*"
확장자, 수정 날짜 또는 크기로 파일을 필터링할 수도 있습니다.
find ~/Documents/stories -type f -iname "*.pdf"
find ~/Documents/stories -type f -mtime -7
find ~/Documents/stories -type f -size +100M
이 명령어들은 각각 PDF 파일, 대략 최근 7일 이내에 수정된 파일, 100MB보다 큰 파일을 찾습니다.
locate로 파일을 더 빠르게 찾기
locate 명령어는 매번 파일 시스템을 스캔하는 대신 파일 이름 데이터베이스를 검색하므로, 일반적으로 find보다 파일 이름 조회 속도가 훨씬 빠릅니다. plocate 설명서에서는 이 색인 기반 조회 방식이 어떻게 작동하는지 설명합니다.
locate -i "profit"
locate는 색인을 사용하므로 최근에 생성된 파일은 데이터베이스가 업데이트될 때까지 표시되지 않을 수 있습니다. 데이터베이스를 갱신할 권한이 있는 시스템에서는 다음을 사용하세요.
sudo updatedb
최신 결과나 세부 필터가 필요하다면 find를 사용하세요. 색인된 위치 전체에서 기존 파일 이름을 가장 빠르게 조회하려면 locate를 사용하세요.

Linux용 최고의 문서 검색 도구
grep과 ripgrep은 일반 텍스트용으로 설계되었습니다. PDF, Word, Excel, LibreOffice, eBook 및 기타 형식을 검색하려면 아래의 문서 검색 애플리케이션 중 하나를 사용하세요. 이미지만 포함된 스캔 PDF는 먼저 OCR 처리가 필요합니다.
다양한 문서 유형이 포함된 폴더를 검색하고, 일치하는 문장을 미리 보며, 터미널을 사용하지 않고 관련성 순으로 정렬된 결과를 확인하고 싶다면 SeekFast가 적합합니다. 새 폴더나 자주 변경되는 폴더를 검색해야 할 때 특히 편리합니다.
무료 오픈 소스 소프트웨어를 선호하고 미리 색인을 생성하는 데 익숙하다면 Recoll과 DocFetcher가 좋은 선택입니다. 색인 생성에는 준비가 필요하지만, 이미 구축된 문서 모음을 반복적으로 검색할 때 더 실용적일 수 있습니다.
ChatGPT 데스크톱 앱은 다른 접근 방식을 사용합니다. 사용자가 선택한 폴더를 처리하고, 자연어 질문에 답하며, 파일을 비교하고, 결과를 요약할 수 있습니다. 정확한 일치 항목을 빠짐없이 검색하는 유일한 도구로 사용하기보다는 정보를 이해해야 할 때 보완 도구로 사용하는 것이 가장 좋습니다.
SeekFast
SeekFast는 Windows, macOS 및 Linux용 문서 검색 도구입니다. 터미널에서 일반 텍스트 파일만 검색하는 대신 대규모 문서 모음 내부를 검색하도록 설계되었습니다.
주요 장점은 편리함입니다. 폴더를 선택하고 검색어를 입력하면 각 파일을 열기 전에 일치하는 문장을 확인할 수 있습니다. 정확한 파일 이름은 모르지만 여러 문서 내부를 검색해야 할 때 유용합니다.
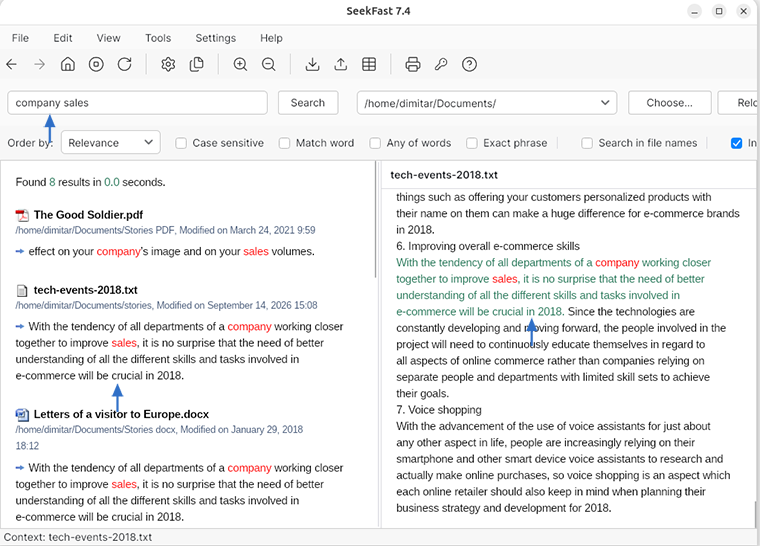
SeekFast는 다양한 형식의 문서가 섞여 있는 폴더에서 특히 유용합니다. 여러 형식의 내부를 검색하고 결과를 관련성에 따라 정렬할 수 있기 때문입니다. 따라서 기존의 정확한 일치 기반 파일 검색보다 웹 검색 환경에 더 가깝습니다.
주요 기능은 다음과 같습니다.
- 문서 검색 - PDF, Word, LibreOffice, Excel, 텍스트 파일 및 eBook을 포함하여 지원되는 120개 이상의 파일 형식을 검색합니다.
- 일치 문장 미리 보기 - 파일을 열기 전에 관련 텍스트를 확인합니다.
- 관련성 순으로 정렬된 결과 - 더 적합하게 일치하는 파일이 결과 상단에 표시됩니다.
- 여러 키워드 검색 - 단어가 서로 인접하지 않아도 문서를 찾습니다.
- 그래픽 기반 작업 방식 - 일반적인 문서 검색 작업을 위해 터미널 명령어를 작성할 필요가 없습니다.
장점
- 실제 문서가 들어 있는 폴더에서는 grep보다 훨씬 편리합니다.
- 문서의 단어는 기억하지만 파일 이름은 기억하지 못할 때 효과적입니다.
- 문맥을 표시하므로 파일을 열기 전에 결과를 평가할 수 있습니다.
- PDF, Office, LibreOffice, 텍스트 및 기타 형식이 섞인 폴더에 유용합니다.
단점
- SeekFast 무료 버전은 한 번에 최대 50개 파일까지만 검색할 수 있습니다.
- 소스 코드 검색에서 grep이나 ripgrep을 대체하기 위한 도구가 아닙니다.
- 전문 명령줄 도구와 같은 고급 정규 표현식 작업 방식을 지원하지 않습니다.
주요 작업이 코드나 로그 파일이 아니라 많은 문서 내부를 검색하는 것이라면 SeekFast를 다운로드하여 문서 폴더 중 하나에서 사용해 보세요.
Recoll
Recoll은 Linux 및 기타 Unix 계열 시스템용 무료 오픈 소스 데스크톱 검색 도구입니다. 색인을 사용하므로 먼저 사용자가 선택한 폴더를 스캔한 다음 빠르게 검색할 수 있도록 합니다.
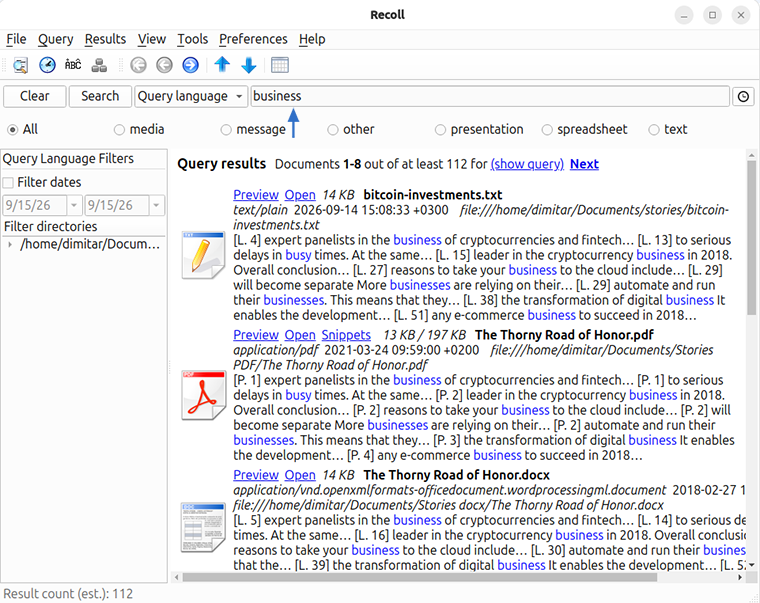
일부 문서 형식의 지원 여부는 시스템에 설치된 보조 애플리케이션에 따라 달라집니다. 오픈 소스 색인 기반 데스크톱 검색 도구를 원하며 설정에 어느 정도 시간을 들여도 괜찮다면 좋은 선택입니다.
장점
- 무료 오픈 소스입니다.
- 색인 기반 Linux 데스크톱 검색 도구로 잘 작동합니다.
- 적절한 보조 프로그램을 사용하면 다양한 문서 형식을 검색할 수 있습니다.
단점
- 초기 색인 생성과 설정에 시간이 걸릴 수 있습니다.
- 일반 사용자에게는 작업 방식이 기술적으로 느껴질 수 있습니다.
- 문서 형식 지원 여부가 설치된 시스템 패키지에 따라 달라질 수 있습니다.
DocFetcher
DocFetcher는 Linux, Windows 및 macOS용 무료 오픈 소스 데스크톱 검색 애플리케이션입니다. DocFetcher Pro는 추가 기능을 제공하는 별도의 유료 버전입니다. Recoll과 마찬가지로 사용자가 선택한 폴더의 색인을 생성하는 방식으로 작동합니다.
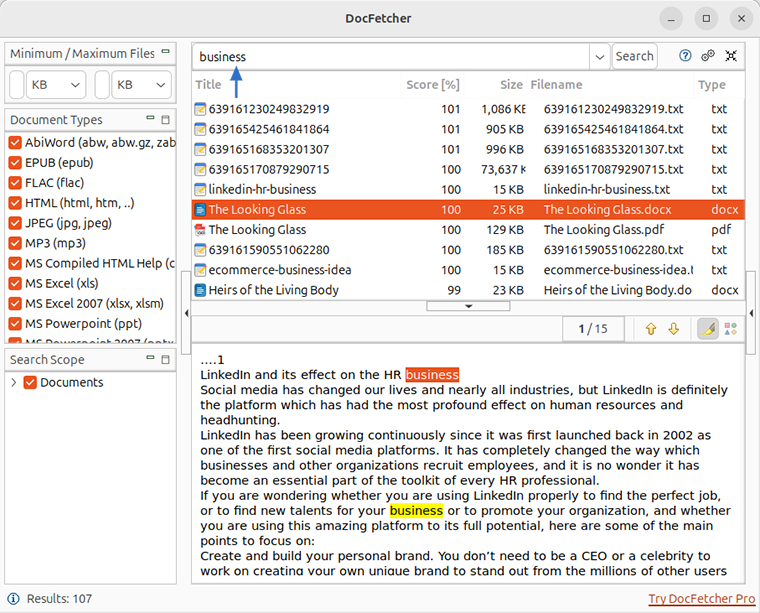
DocFetcher는 PDF, Microsoft Office, OpenDocument, HTML 및 일반 텍스트와 같은 일반적인 문서 형식을 지원합니다. 무료 크로스 플랫폼 도구를 원하고 검색 전에 색인을 생성하는 데 익숙하다면 유용합니다.
장점
- 표준 DocFetcher 버전은 무료 오픈 소스입니다.
- Linux, Windows 및 macOS에서 사용할 수 있습니다.
- 색인된 문서의 텍스트 미리 보기를 표시할 수 있습니다.
단점
- 폴더 내용을 검색하려면 먼저 색인을 생성해야 합니다.
- 인터페이스가 많은 최신 검색 도구보다 오래되어 보입니다.
- 색인을 준비하지 않고 일회성 폴더를 자주 검색한다면 덜 편리합니다.
ChatGPT 데스크톱 앱
ChatGPT 데스크톱 앱은 지원되는 Linux 배포판에서 프리뷰 버전으로 제공됩니다. 전통적인 파일 검색 프로그램이 아니라 사용자가 선택한 폴더의 파일을 처리할 수 있는 AI 작업 공간입니다.
로컬 파일과 함께 사용하려면 ChatGPT Work 또는 Codex에서 로컬 폴더를 열고 사용할 파일에 대한 접근 권한을 부여하세요. 그런 다음 다음과 같이 자연어로 질문할 수 있습니다.
- "비즈니스 위험을 논의하는 문서를 찾아 줘."
- "판매 보고서를 비교하고 가장 중요한 차이점을 보여 줘."
- "이 프로젝트와 관련된 정보를 찾아서 요약해 줘."
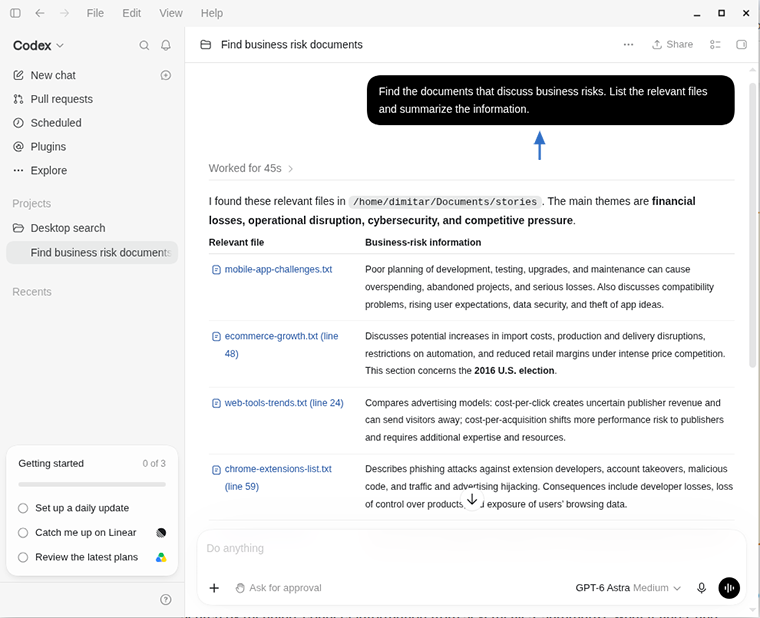
이 접근 방식은 정확한 표현을 기억하지 못할 때 가장 유용합니다. ChatGPT는 의미를 기준으로 검색하고, 여러 파일의 정보를 연결하며, 찾은 내용을 요약하고, 결과를 설명하는 데 도움을 줄 수 있습니다. Codex는 소스 코드 프로젝트도 검색하고 분석할 수 있습니다.
장점
- 키워드나 정규 표현식뿐 아니라 자연어 질문도 사용할 수 있습니다.
- 여러 파일의 정보를 요약하고 비교하며 해석할 수 있습니다.
- 단순히 구문을 찾는 데서 끝나지 않고 결과를 이해하는 것이 다음 단계일 때 유용합니다.
단점
- 모든 정확한 일치 항목을 보장하도록 설계되지 않았으므로 완전성이 중요할 때는 grep 또는 ripgrep을 사용하세요.
- SeekFast, Recoll 또는 DocFetcher와 같은 전용 색인 검색 작업 방식을 제공하지 않습니다.
- Linux 버전은 아직 프리뷰 단계이며 공식적으로 일부 배포판만 지원합니다.
- ChatGPT 계정이 필요하며 완전히 오프라인으로 작동하는 대신 온라인 서비스를 사용합니다. 민감한 문서에 사용하기 전에 OpenAI가 ChatGPT 및 Codex 데이터를 사용하는 방식과 개인정보 보호 요구 사항을 검토하세요.
ChatGPT는 기존 검색 도구의 보완 수단으로 사용하세요. 정확한 텍스트 검색에는 grep과 ripgrep이 더 적합하고, 예측 가능한 결과로 문서 모음을 탐색하려면 문서 검색 애플리케이션이 더 적합하며, 찾은 정보를 이해하고 비교하거나 요약하려면 ChatGPT가 유용합니다.
결론
이 글에서는 Linux에서 파일을 찾고 파일 내용을 검색할 때 테스트에서 가장 효과적이었던 방법을 소개했습니다. 하지만 Linux 사용자는 저마다 선호하는 도구와 작업 방식을 가지고 있는 경우가 많습니다. 여러분은 어떤 방법을 사용하시나요? 제가 놓친 유용한 명령어나 애플리케이션이 있나요?
다음 방법 중 하나로 경험을 공유할 수 있습니다.
- 아래 양식을 사용하여 댓글을 남겨 주세요.
- Reddit 토론에 참여하세요.
자주 묻는 질문
1. Linux에서 이름으로 파일을 찾으려면 어떻게 해야 하나요?
find 명령어를 사용하세요. 예:
find ~/Documents/stories -type f -iname "*profit*"
이 명령어는 대소문자를 구분하지 않고 stories 폴더와 하위 폴더에서 파일 이름에 "profit"이 포함된 파일을 검색합니다.
2. find와 grep의 차이점은 무엇인가요?
find 명령어는 파일 이름, 경로 및 파일 속성을 검색합니다. grep 명령어는 일반 텍스트 파일 내부에 저장된 텍스트를 검색합니다. 파일 이름을 알고 있다면 find를 사용하고, 파일에 있는 단어를 기억한다면 grep 또는 문서 검색 도구를 사용하세요.
3. find와 locate 중 무엇을 사용해야 하나요?
최신 결과와 세부 필터에는 find를 사용하세요. 미리 구축된 색인에서 파일 이름을 더 빠르게 조회하려면 locate를 사용하세요. 새로 생성된 파일은 데이터베이스가 업데이트될 때까지 locate에 나타나지 않을 수 있습니다.
4. Linux 폴더의 모든 파일에서 텍스트를 검색하려면 어떻게 해야 하나요?
grep -R 명령어가 표준 선택입니다. 예:
grep -RIn "budget" ~/Documents/stories
일반 텍스트 파일, 소스 코드, 로그 및 설정 파일에 가장 적합합니다.
5. 하위 폴더도 함께 검색하려면 어떻게 해야 하나요?
grep -R로 재귀 검색을 사용하세요.
grep -RIn "budget" ~/Documents/stories
이 명령어는 stories 폴더와 하위 폴더를 검색하고, 바이너리 파일을 건너뛰며, 줄 번호를 표시합니다.
6. 특정 파일 유형만 검색하려면 어떻게 해야 하나요?
--include를 사용하세요. 예:
grep -RIn --include="*.txt" "budget" ~/Documents/stories
여러 확장자를 검색하려면 --include를 반복해서 사용할 수 있습니다.
7. grep 검색에서 폴더를 제외하려면 어떻게 해야 하나요?
--exclude-dir을 사용하세요. 예:
grep -RIn --exclude-dir="archive" --exclude-dir="drafts" "risk" ~/Documents/stories
8. 여러 단어 중 하나를 검색하려면 어떻게 해야 하나요?
각 문자열에 -e 옵션을 하나씩 추가하세요. 예:
grep -RIn -e "sales" -e "budget" -e "payment" ~/Documents/stories
이 명령어는 문자열 중 하나라도 포함된 줄을 찾습니다.
9. ripgrep이 grep보다 더 좋은가요?
ripgrep은 대규모 코드 및 텍스트 폴더를 재귀적으로 검색할 때 더 빠르고 편리한 경우가 많습니다. 반면 grep 명령어는 거의 모든 Linux 시스템에서 기본적으로 사용할 수 있으며 일반적인 텍스트 검색에 적합합니다. 둘 다 범용 문서 검색 도구는 아닙니다.
10. grep이 PDF나 Word 파일 내부의 텍스트를 찾지 못하는 이유는 무엇인가요?
grep 명령어는 일반 텍스트용으로 설계되었습니다. PDF, Word, LibreOffice 및 Excel 파일은 텍스트를 더 복잡한 형식으로 저장하므로 grep이 일치 항목을 놓치거나 읽을 수 없는 출력을 표시할 수 있습니다. 이러한 파일에는 문서 검색 도구를 사용하세요.
11. Linux에서 PDF, Word 및 LibreOffice 파일 내부를 검색하는 가장 좋은 방법은 무엇인가요?
문서 형식을 인식하는 검색 도구를 사용하세요. 미리 보기와 관련성 순으로 정렬된 결과를 원한다면 SeekFast가 편리합니다. 색인 기반 데스크톱 검색을 선호한다면 Recoll과 DocFetcher가 좋은 오픈 소스 대안입니다.
12. SeekFast는 Linux에서 작동하나요?
예. SeekFast에는 Linux 버전이 있으며 그래픽 인터페이스에서 다양한 문서 형식의 내부를 검색할 수 있습니다.
13. grep, ripgrep, SeekFast 중 무엇을 사용해야 하나요?
일반적인 일반 텍스트 검색에는 grep을 사용하세요. 코드 및 텍스트 폴더를 빠르게 재귀 검색하려면 ripgrep을 사용하세요. PDF, Word, LibreOffice, Excel 및 기타 문서 내부를 미리 보기와 함께 검색해야 한다면 SeekFast를 사용하세요.
